Modellkandidaten vergleichen und jeden davon exportieren
Zwischen Random Forest, XGBoost und mehreren Suchstrategien für neuronale Netze von Hand zu wählen bedeutet, jedes Modell einzeln zu trainieren und die Ergebnisse manuell gegenüberzustellen. Der Modellwettbewerb von Data Sensors trainiert alle gleichzeitig auf denselben Messdaten, bewertet sie nach zurückgehaltener Validierungsgenauigkeit und lässt jeden Eintrag der Bestenliste nach C, C++, Python oder MATLAB exportieren.
Mehrere Modelltypen gleichzeitig trainieren, nicht nacheinander
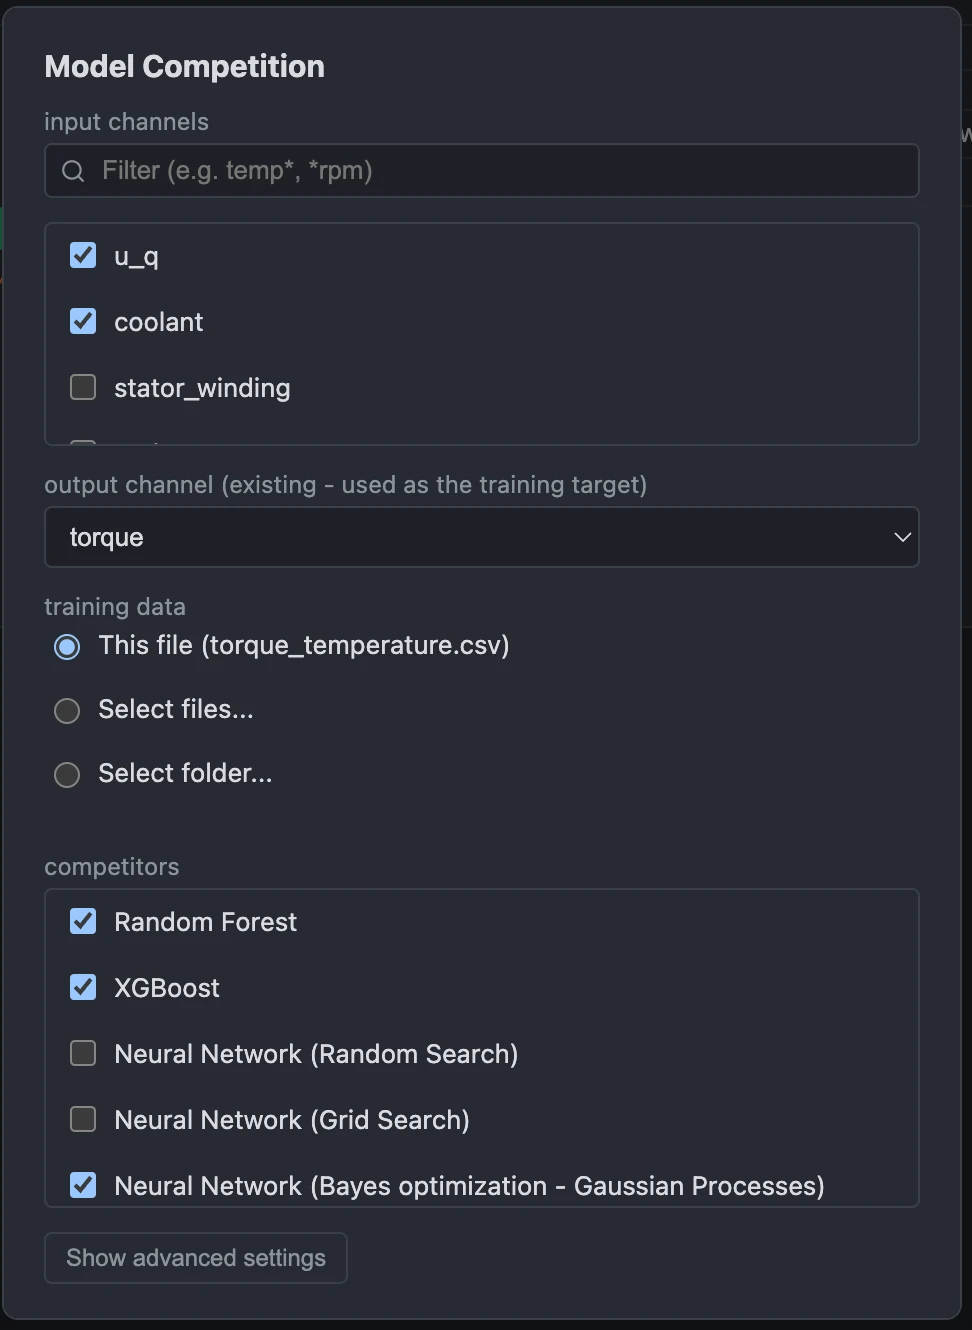
Wählen Sie eine beliebige Kombination aus Random-Forest-, XGBoost- und Neuronale-Netz-Kandidaten, jeweils mit eigener Suchstrategie - Zufallssuche, Rastersuche, Bayes-Optimierung (Gauß-Prozess) oder eine Random-Forest-/XGBoost-Surrogatsuche - und alle trainieren gleichzeitig gegen dieselben Eingangs-/Ausgangskanäle. Auto-Tuning ist nicht auf neuronale Netze beschränkt: Auch Random-Forest- und XGBoost-Kandidaten können jeweils ihre eigenen Hyperparameter automatisch optimieren, sodass für einen abgestimmten Vergleich nicht drei unterschiedliche Hyperparameterräume von Hand durchsucht werden müssen. Der Trainingsdialog muss nicht für jeden Kandidaten erneut geöffnet und die Ergebnisse müssen nicht in einer eigenen Tabelle festgehalten werden.
Bewertung auf einem zurückgehaltenen Validierungsanteil
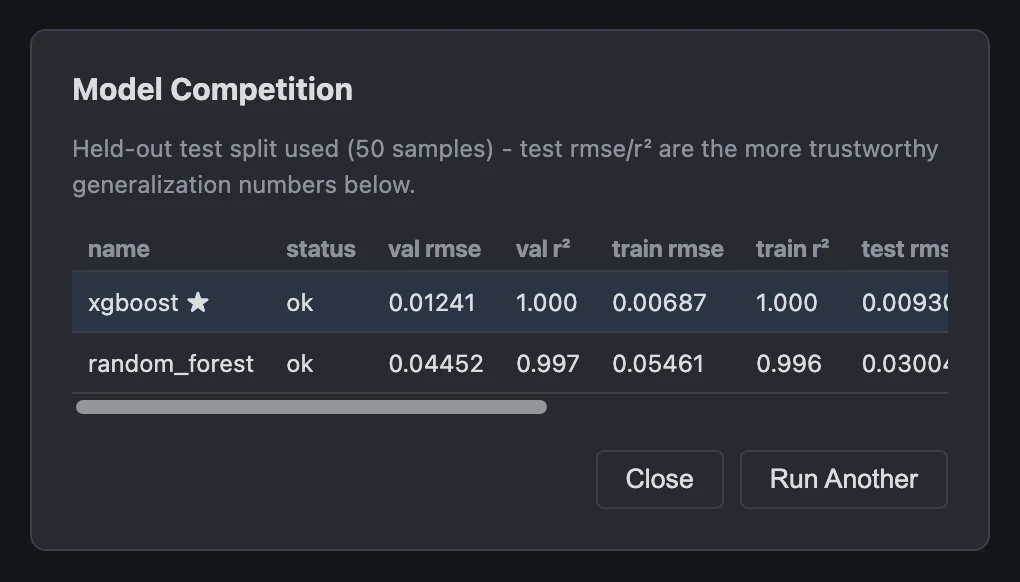
Jeder Kandidat wird auf Daten bewertet, auf denen er nicht trainiert wurde. Die Bestenliste zeigt damit, wie gut ein Modell generalisiert, und nicht, wie genau es die Trainingsdaten abbildet. Sie führt Validierungs-RMSE und R² für jeden Eintrag nebeneinander auf, zusammen mit Trainingszeit und einer Anpassungsdiagnose, aus der hervorgeht, ob ein Kandidat unterangepasst, überangepasst oder konkurrenzfähig ist.
Ein separater Testanteil für größere Datensätze
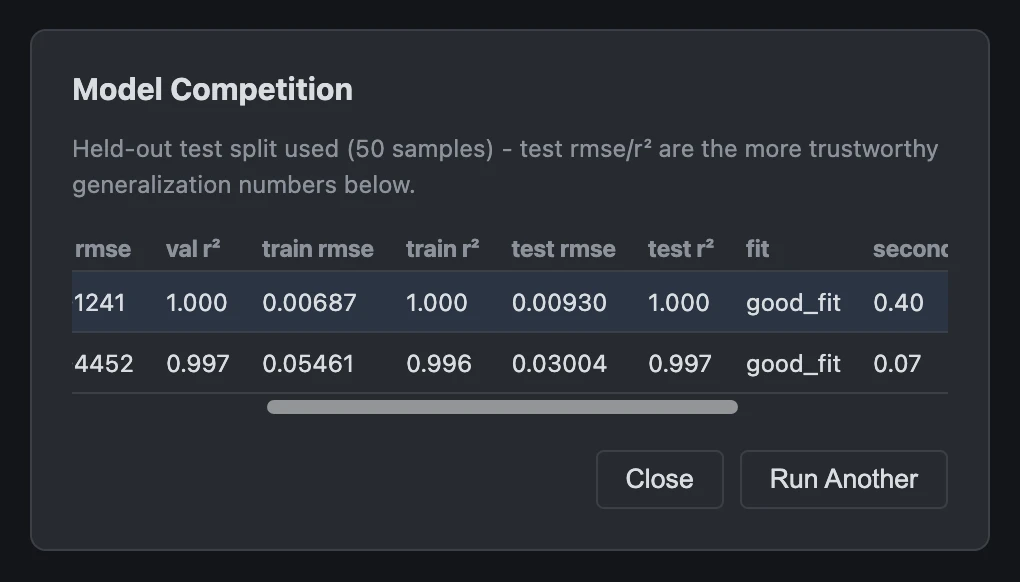
Die Bewertung der Bestenliste fällt tendenziell zu optimistisch aus, da sie selbst zur Auswahl des besten Modells dient. Für ausreichend große Datensätze trennt Data Sensors deshalb automatisch einen zusätzlichen Testanteil ab, bevor eine Bewertung stattfindet. Dieser wird weder beim Training noch bei der Modellauswahl verwendet und liefert einen zweiten, verlässlicheren Satz von Genauigkeitswerten für das Modell, das Sie tatsächlich einsetzen wollen.
Den Gewinner exportieren - oder jeden anderen Eintrag
Das bestbewertete Modell ist nicht in jedem Fall die richtige Wahl: Ein etwas weniger genauer Random Forest kann auf Ihrer Zielhardware schneller laufen, ein kleineres neuronales Netz besser in Ihr Flash-Budget passen. Jeder Eintrag der Bestenliste, nicht nur der Gewinner, kann nach C, C++, Python oder MATLAB exportiert werden, in voller Genauigkeit oder int8-quantisiert, mit einer Live-Vorschau von Größe und Genauigkeit vor dem Speichern. Siehe Virtuellen Sensor trainieren, um ein einzelnes Modell direkt zu trainieren, ohne einen vollständigen Wettbewerb zu starten.