Trainieren Sie einen virtuellen Sensor aus Messdaten
Data Sensors trainiert Random-Forest-, XGBoost- und neuronale Netzmodelle direkt auf Ihren eigenen Aufzeichnungen - ohne Cloud-Upload, ohne Labeling-Pipeline und ohne separate Python-Umgebung. Wählen Sie eine Messdatei aus, bestimmen Sie die Eingangskanäle und das nachzubildende Zielsignal, und lassen Sie ein passendes Modell suchen.
Eine Datei, mehrere Dateien oder ein ganzer Ordner
Die meisten Werkzeuge zur Sensormodellierung setzen voraus, dass die Trainingsdaten in einer einzigen Datei vorliegen. Messkampagnen in der Praxis verlaufen anders: Ein Datenlogger läuft voll, ein Test verteilt sich über mehrere Sitzungen, oder das Training soll alle aufgezeichneten Fahrzyklen umfassen, nicht nur den letzten. Data Sensors trainiert sequenziell über beliebig viele Dateien und fügt sie zu einem Datensatz zusammen - selbst wenn dasselbe physikalische Signal in verschiedenen Dateien unter unterschiedlichem Kanalnamen protokolliert wurde: eine Zuordnungstabelle lässt Sie den richtigen Kanal je Datei einmal zuweisen und diese Zuordnung später als gespeicherte CSV-Datei wiederverwenden.
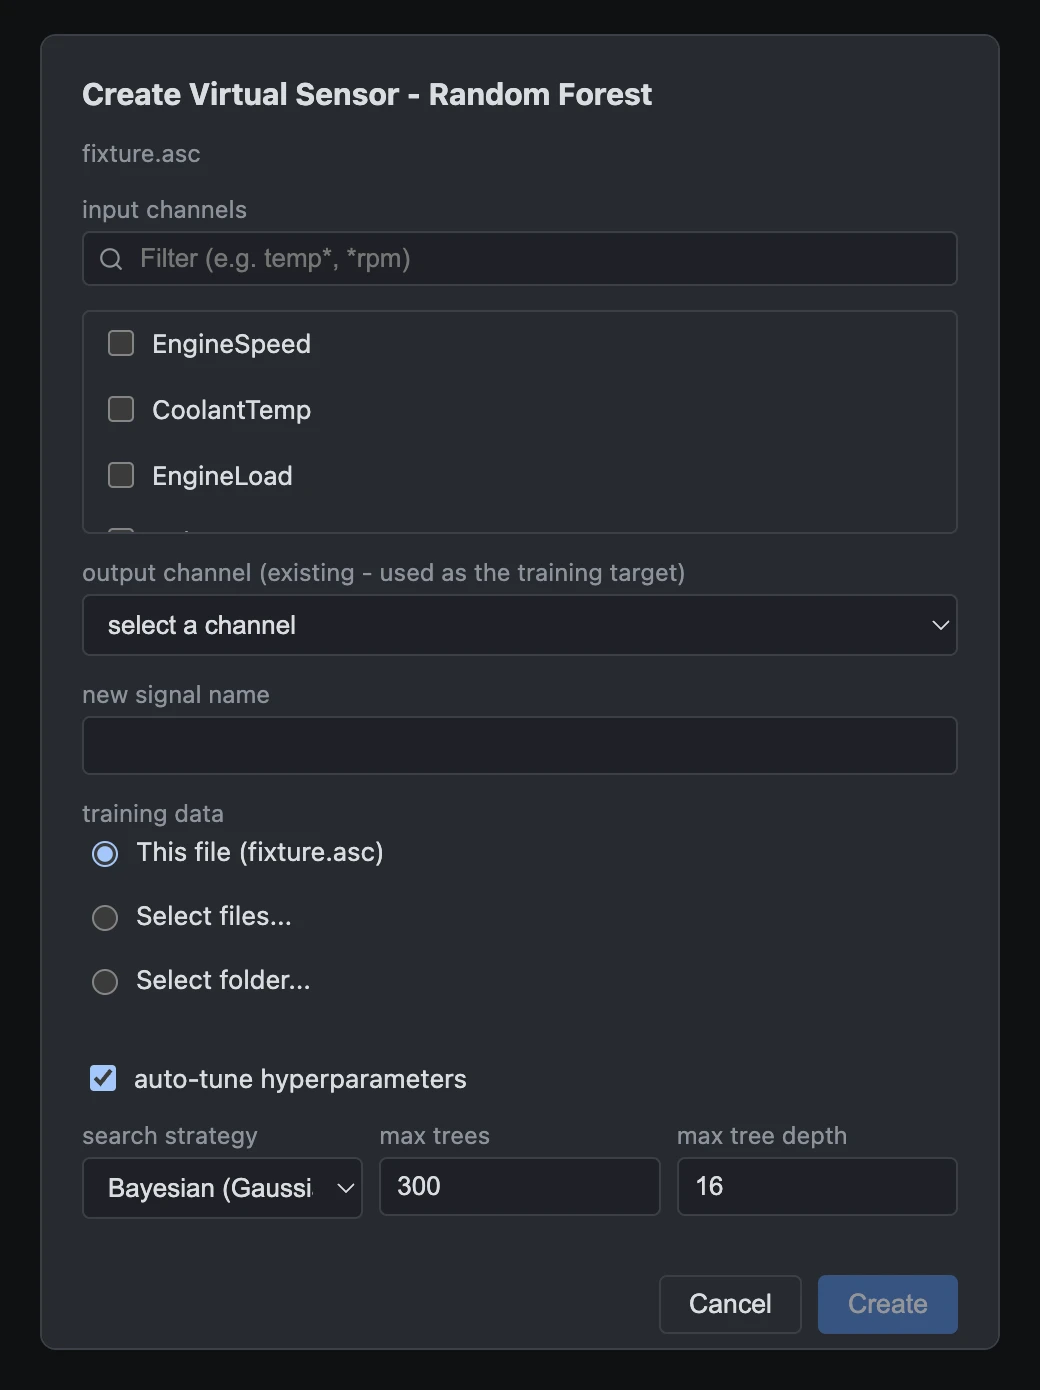
Random Forest, XGBoost oder neuronales Netz
Es gibt keine Modellfamilie, die für jedes Sensormodellierungsproblem die beste ist: Ein Random Forest ist oft der schnellste Weg zu einer belastbaren Basislinie, Gradient-Boosted Trees (XGBoost) erreichen bei strukturierten tabellarischen Signalen häufig eine höhere Genauigkeit, und ein neuronales Netz ist meist die richtige Wahl, wenn der Zusammenhang zwischen Eingang und Ziel glatt und stark nichtlinear ist. Alle drei lassen sich in Data Sensors direkt trainieren; ist unklar, welches Modell auf Ihren Daten am besten abschneidet, trainiert der Modellwettbewerb alle gleichzeitig und bewertet sie.
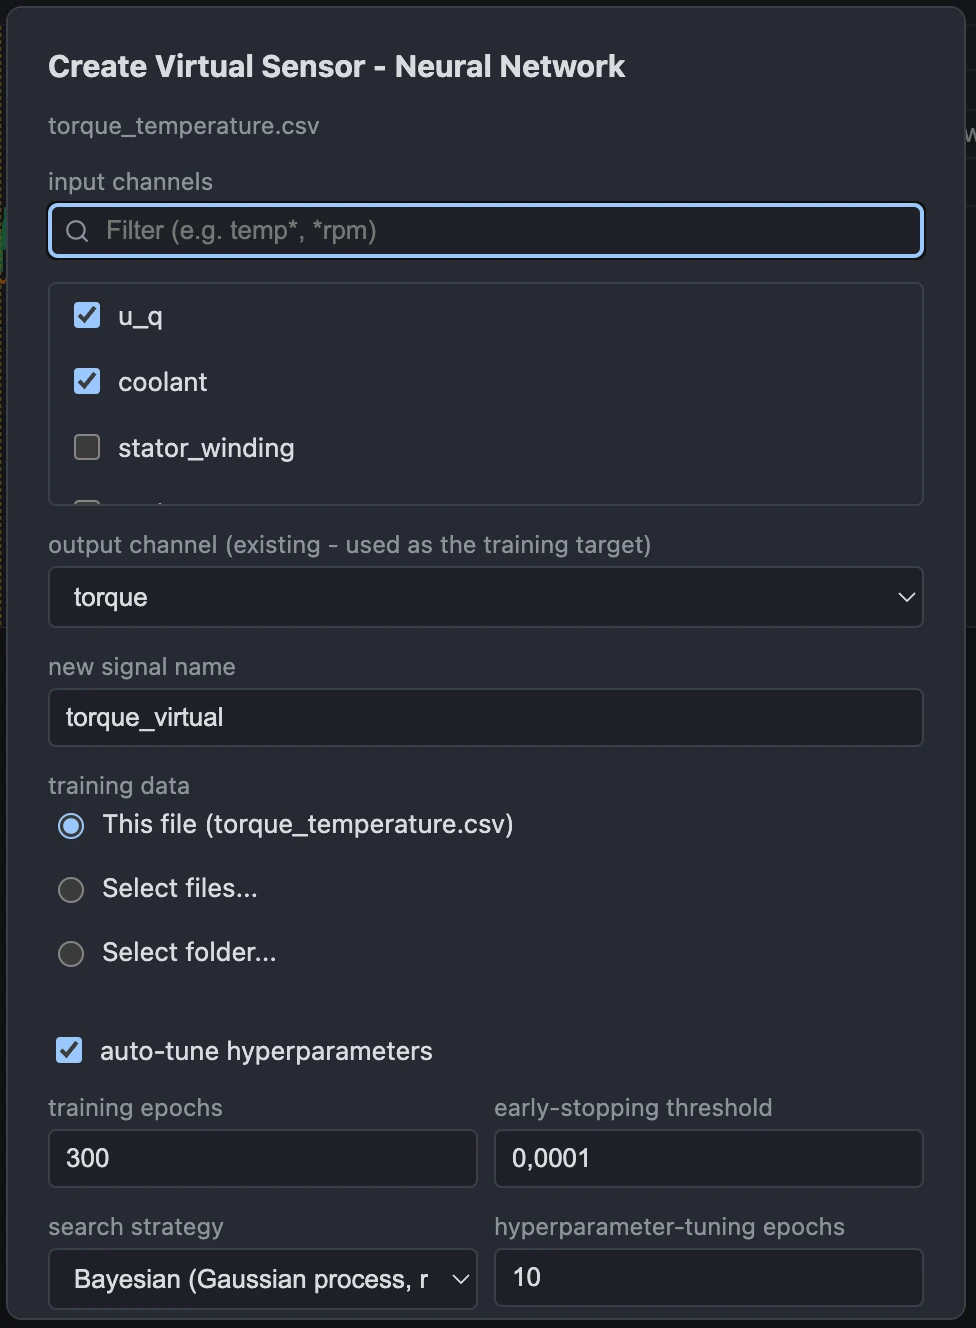
Auto-Tuning ohne manuell gewählte Hyperparameter
Alle drei Modelltypen können ihre eigenen Hyperparameter automatisch optimieren, statt manuell gewählte Werte zu erfordern. Random Forest durchsucht Baumanzahl, maximale Tiefe und minimale Blattgröße; XGBoost durchsucht Baumanzahl, maximale Tiefe und Lernrate; das neuronale Netz durchsucht Schichtanzahl, Neuronen pro Schicht und Lernrate. Jeder Modelltyp kann per Bayes-Optimierung (Gauß-Prozess, Standard), Zufallssuche, Rastersuche oder einer Random-Forest-/XGBoost-Surrogatstrategie automatisch abgestimmt werden - je nachdem, wie viel Rechenzeit Sie investieren möchten. Beim Training auf mehreren Dateien läuft die Suche selbst gegen eine einzelne repräsentative Datei, um schnell zu bleiben; anschließend wird die beste Konfiguration auf dem vollständigen Datensatz aus mehreren Dateien neu trainiert.
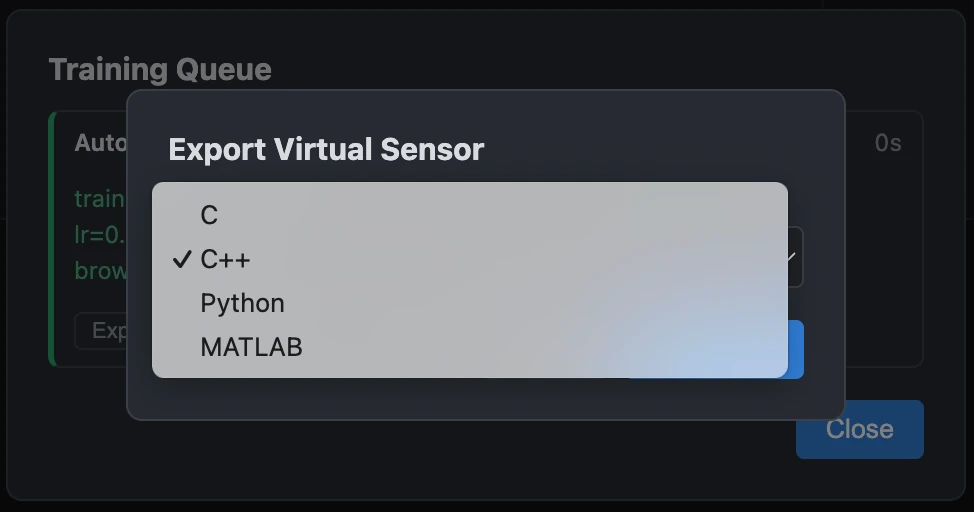
Vom Training zu eigenständigem Code, ohne die App zu verlassen
Ein trainiertes Modell ist erst dann nützlich, wenn es im Zielsystem läuft - auf einem Steuergerät, in einem Simulink-Block oder in einem Python-Analyseskript. Jedes von Data Sensors trainierte Modell kann direkt nach C, C++, Python oder MATLAB exportiert werden, in voller Genauigkeit oder int8-quantisiert, mit einer Live-Vorschau von Größe und Genauigkeit vor dem Speichern. Siehe Modellwettbewerb, um mehrere Modelltypen gleichzeitig zu trainieren und vor dem Export zu vergleichen.
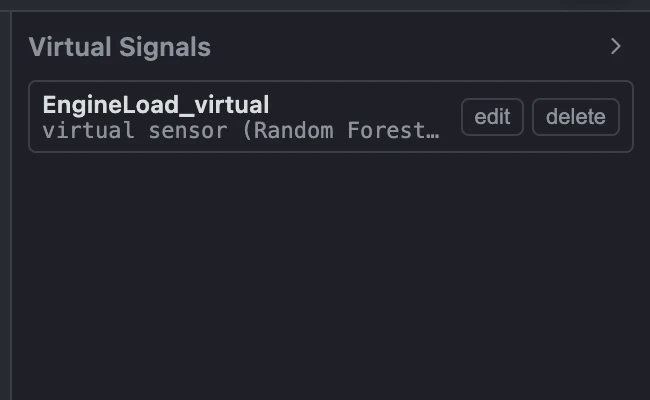
Jeder trainierte Sensor erscheint im Panel für virtuelle Signale
Jedes von Ihnen trainierte Modell - ob aus diesem Dialog, aus einem Eintrag des Modellwettbewerbs oder durch den Rückimport eines zuvor exportierten C-, C++- oder Python-Modells - erscheint als Signal in einem eigenen Panel für virtuelle Signale, getrennt von Ihren realen Kanälen und berechneten Signalen. Benennen Sie jedes davon jederzeit um oder löschen Sie es; beim Umbenennen greift dieselbe Eindeutigkeitsprüfung für Namen, die auch sonst überall in der App verwendet wird, sodass ein virtueller Sensor nie mit einem realen Kanal oder einem berechneten Signal kollidieren kann. Ein bereits exportiertes Modell lässt sich zurückimportieren: Ordnen Sie einmalig seine Eingangskanäle zu, und es läuft direkt gegen die aktuell geladene Messung, ohne erneutes Training.