モデルコンペティション
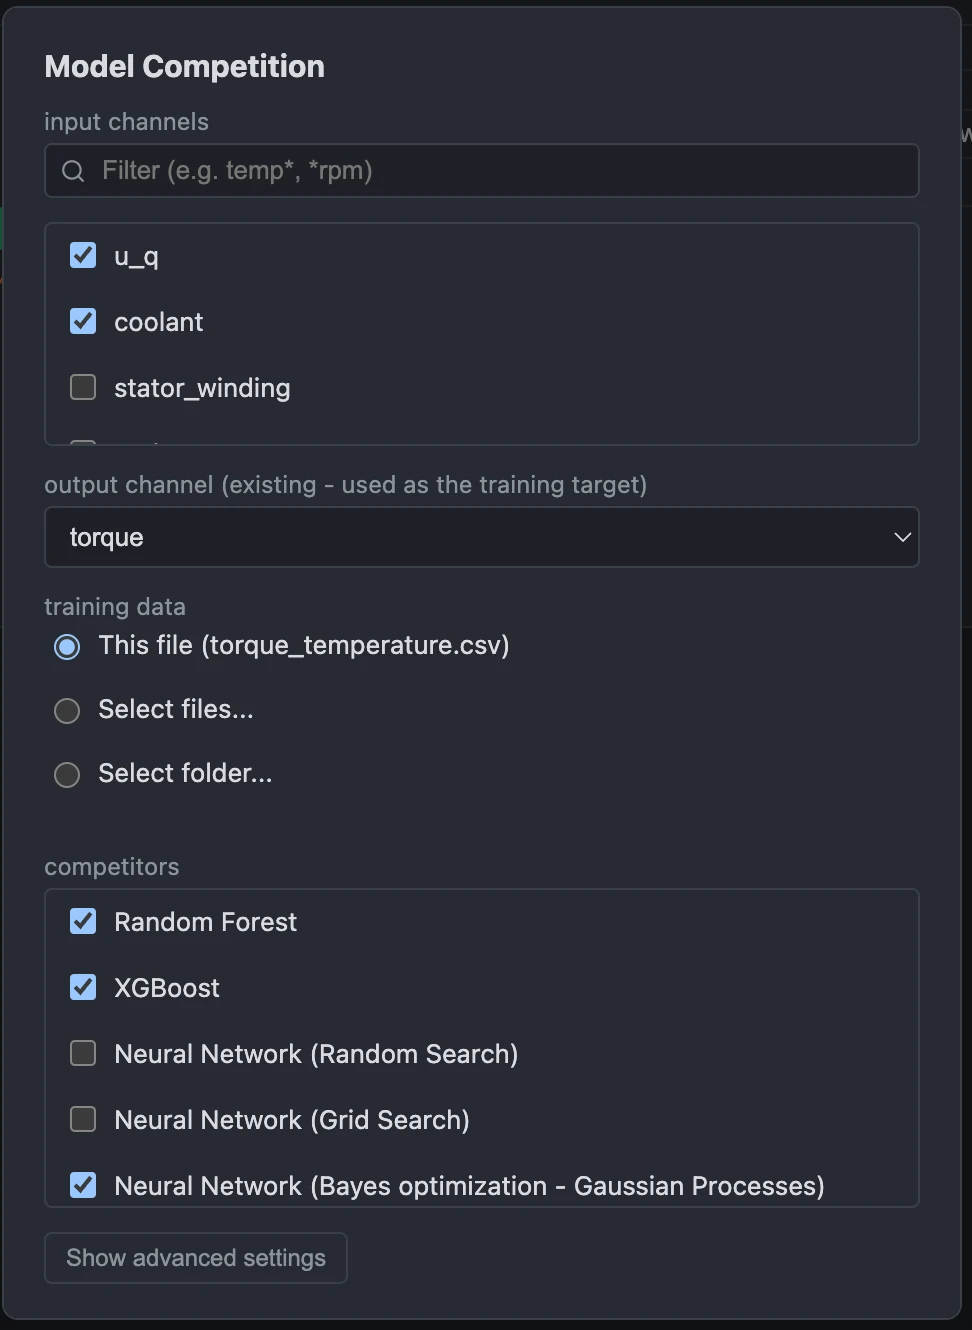
1つのモデルタイプだけをトレーニングして、それが正しい選択であることを期待する代わりに、 コンペティションの実行では、ランダムフォレスト、XGBoost、ニューラルネットワークの候補を任意 の組み合わせで、同じ入力/出力チャンネルに対して同時にトレーニングします - ニューラルネット ワークだけでなく、木ベースの候補についても自動調整が適用されます。各候補は、一度もトレーニング に使われていない保留検証データで評価され、ランキングには各エントリの検証RMSEとR²が並べて 表示されるほか、トレーニング時間や適合診断(未学習、過学習、あるいは十分な競争力があるか)も 確認できます。十分な大きさのデータセットについては、トレーニングやモデル選定には一度も使用され ない、2つ目の未使用テストセットが用意され、実際に展開する予定のエントリについて、より信頼 できる精度の数値が得られます。ランキング上のエントリは、勝者に限らず、どれでもコードとして エクスポートできます - ただしエクスポートにはVirtual Sensorライセンスが必要で、候補の トレーニングと比較自体はViewerライセンスで行えます。
候補モデルがまだ実行中の間、その横に表示される数値はフェーズによって意味が異なります: チューニング中はこれまでに見つかった最良のハイパーパラメータの組み合わせであり、再トレーニング が始まると、優勝した構成自体の実際にまだ収束途中のスコアに変わります。この数値は再トレーニング 開始直後は一時的に悪く見えることがありますが、その後チューニングフェーズの最良値を再び 上回ります - これは想定内の挙動であり、後退ではありません。